Линейная и полиномиальная регрессия
- Что такое линейная регрессия и зачем нужна?
- Как выглядит функция потерь и её формула (MSE)?
- Что такое метод наименьших квадратов и почему его используют?
- Какие гиперпараметры есть у линейной регрессии?
- Что такое полиномиальная регрессия и чем она отличается от линейной?
- Какие бизнес-метрики применимы для регрессии? (MAE в рублях, MAPE и др.)
- Кто более устойчив к выбросам — MSE или MAE — и почему?
- Как строится линейная модель? Что означает «обучить модель»?
- Что под капотом у линейной регрессии из sklearn?
- Какая предобработка данных нужна для линейных моделей?
Логистическая регрессия
- Что такое логистическая регрессия и зачем нужна?
- Как выглядит её функция потерь (log-loss)?
- Как из линейной регрессии получить логистическую (сигмоидальная трансформация)?
- Что такое отступ (margin) и зачем он нужен?
- Как записать логистическую регрессию математически?
- Запиши функцию сигмоиды. Какие у неё значения в нуле и на бесконечностях?
- Какой loss минимизируется в логистической регрессии?
- Выведи log-loss из правдоподобия для бинарного случая.
- Учитывается ли свободный член b в оптимизации?
- Чем инициализируют веса в начале обучения? Почему не нулями? Почему не большими числами?
- Используется ли свободный член b в регуляризации?
- Зачем нормировать признаки для логистической регрессии?
KNN
- Что такое KNN и для каких задач применяется?
- Учится ли что-то KNN во время тренировки?
- Какие метрики расстояния можно использовать?
- Как поступать при чётном числе ближайших соседей (ничья)?
Деревья решений и случайный лес
- Как работает дерево решений? (жадный алгоритм, критерии Gini, энтропия)
- Как выбирается порог отсечения признака?
- Какие гиперпараметры у деревьев (максимальная глубина, минимальное число образцов в листе и др.)?
- Что такое случайный лес и как он агрегирует ответы?
- Что такое bootstrap-выборка и зачем она нужна в лесах?
- Как обрабатываются категориальные признаки?
- Могут ли деревья переобучаться при увеличении числа деревьев?
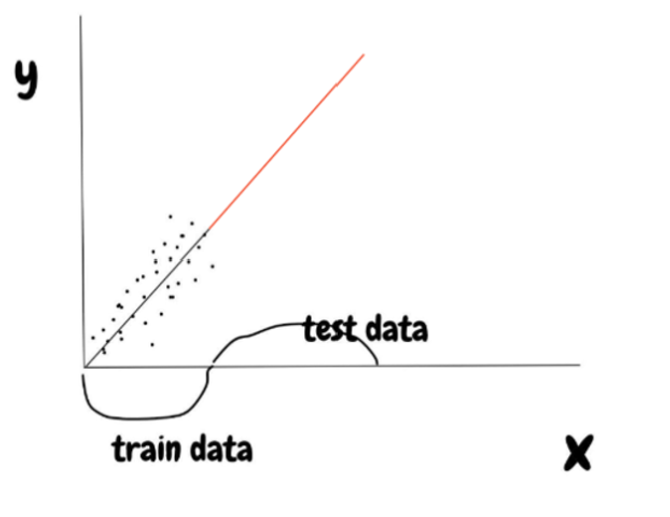
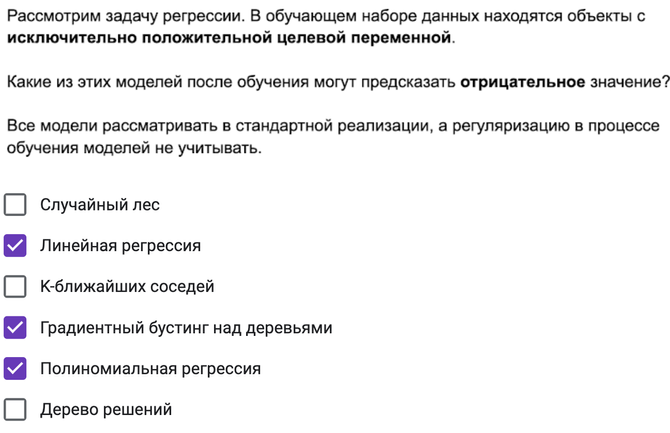
- Если одно дерево решений — могло ли оно выходить за рамки обучающей выборки?
- Почему деревья плохо экстраполируются?
- Как строится дерево решений? Какие у него плюсы и минусы?
- Как дерево используется на инференсе?
- Почему одно дерево на практике не используется?
- Как обучается Random Forest?
- Чего именно RF уменьшает: bias или variance?
- Чем бустинг отличается от бэггинга?
- Почему RF уменьшает дисперсию?
- Как в RF строятся деревья?
- Какой бы выбрали между Random Forest и Gradient Boosting для прогнозирования временных рядов?
- Какие критерии при выборе между Random Forest и Gradient Boosting?
Кластеризация и понижение размерности
- Какие алгоритмы кластеризации знаешь? (K-Means, DBSCAN и др.)
- В чём разница между K-Means и DBSCAN?
- Как выбрать число кластеров (метод локтя, силуэт)?
- Какие метрики кластеризации применяют? (intra-/inter-cluster distance, Dunn index и др.)
- Для чего нужен PCA и как он работает?
- Зачем стандартизировать данные перед применением PCA?
- Какие фичи использовать в K-means? Только внутренние данные или внешние тоже?
- Какие ограничения у классической RFM-сегментации? Какие признаки добавляют для их преодоления?
- В каких случаях GMM-кластеризация выигрывает у K-Means?
- Если фичей 2000, как подходить к их отбору? PCA, корреляции, feature importance?
Ошибки, функции потерь и метрики
- Что такое ошибка обучения?
- Что такое лосс-функция?
- Чем лосс отличается от метрик?
- Какие метрики для регрессии знаете? (MSE, MAE и др.)
- Какие метрики для классификации знаете? (precision, recall, F1, ROC-AUC и др.)
- Как считать precision, recall и F1 (формулы, гармоническое среднее, роль β)?
- Что такое PR-кривая и как с её помощью подбирать порог?
- Что такое ROC-AUC и как на него влияют дублирование примеров или константная модель?
- Какие метрики ранжирования знаете? (P@k, MAP, NDCG и др.)
Доменные вопросы и дисбаланс
- Что такое domain gap?
- Что делать, если выборка несбалансированна?
- Какие метрики устойчивы к дисбалансу?
- Какие способы борьбы с дисбалансом классов знаешь?
Переобучение, недообучение и bias-variance
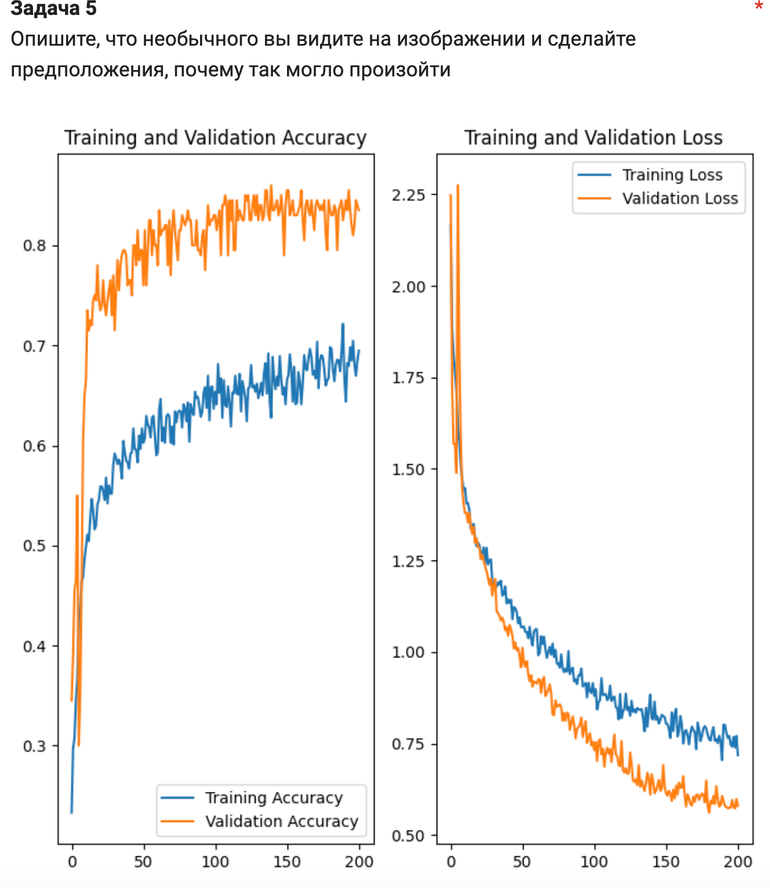
- Что такое переобучение и недообучение?
- Как следить за переобучением?
- Что такое bias-variance tradeoff?
- Если bias высок, это недообучение или переобучение?
- Как регуляризация (L1, L2, dropout) влияет на bias и variance?
- Что будет с bias/variance при:
- увеличении K в KNN
- ограничении глубины дерева
- использовании dropout в нейросетях
- Что такое bias-variance trade-off и как он связан со сложностью моделей?
- У сложных моделей больше смещение или разброс?
- Как понять, что модель переобучилась?
- Какие методы борьбы с переобучением (регуляризация, меньше параметров, больше данных, кросс-валидация)?
Регуляризация
- Какие способы регуляризации нейронных сетей знаешь? (dropout, weight decay и др.)
- Как происходит регуляризация в линейных моделях? (L1 vs L2, elastic net)
- Почему L1 зануляет веса, а L2 нет?
- Что такое регуляризация? Чем отличается L1 от L2?
- Запиши формулу L1-регуляризации (добавка к log-loss).
Градиентный спуск и аналитические решения
- Как работает градиентный спуск?
- Почему для решения задачи регрессии с MSE часто используют градиентный спуск, а не аналитическую формулу? (вычислительная сложность, инверсия больших матриц и др.)
- Как посчитать градиент в точке?
- Что такое градиентный спуск и какие методы существуют?
- Какие модификации шага в градиентном спуске? (про Adam)
- Выполните шаги градиентного спуска для функции x², начальной точки x₀ = 2 и learning rate 1. Что произойдёт?
Бэггинг и бустинг
- Что такое bagging?
- Что будет, если сделать bagging над линейными алгоритмами?
- Почему bagging работает с деревьями и какую технику они используют для разнообразия?
- Что такое boosting? Чем AdaBoost отличается от градиентного бустинга?
- Где “градиент” в градиентном бустинге и какая целевая переменная у n-ого дерева?
- Какие реализации градиентного бустинга знаешь? (XGBoost, LightGBM, CatBoost)
- Чем отличается бустинг от бэггинга?
- Какие ансамблевые методы ещё существуют? (stacking и др.)
- Что больше склонно к переобучению — случайный лес или градиентный бустинг?
- Почему в продакшене для быстрого инференса часто предпочитают бустинг, а не случайный лес?
- Как бустинговые алгоритмы влияют на bias и variance?
- Может ли бустинг выдавать значения, на которых он не обучался?
- Может ли бустинг экстраполировать?
- Как CatBoost обрабатывает категориальные фичи?
- Может ли LightGBM переобучаться из-за того, что строит деревья вглубь?
- Какие способы регуляризации на уровне метрики и структуры бустинга?
- Как объяснить результаты бустинга бизнесу?
- Чем отличаются бустинги друг от друга (CatBoost, LightGBM, XGBoost)?
- Как строятся деревья в каждой из этих реализаций?
- Что произойдёт, если выкинуть первые 30 деревьев из бэггинга и бустинга?
- Что такое bootstrap + aggregation?
- Зачем нужна кросс-валидация?
- Как работает бутстрэп?
- Почему в Random Forest обычно используют глубокие деревья, а в градиентном бустинге — неглубокие?
- Как обрабатывать категориальные признаки в градиентном бустинге?
Выбор признаков и работа с данными
- Как производить отбор признаков? (filter, wrapper, embedded методы)
- Что такое forward/backward selection?
- Как понижать размерность датасета?
- Какие методы идентификации выбросов знаешь?
- Что такое корреляция и ковариация, как они связаны?
- Что такое мультиколлинеарность и стоит ли с ней бороться в логистической регрессии?
- Как бороться с пропусками (NaN) и нулями в данных?
- Почему дереву не нужно масштабировать фичи?
- Как кодировать категориальные данные?
- Как предобрабатывать числовые признаки для линейной модели?
- Что такое утечка таргета (target leakage) и как её избегать в роллингах / лагах?
- Что такое подгонка под тест и как её избежать? Зачем нужен holdout?
Общие ML-концепции
- Что такое задача регрессии, классификации, кластеризации и матчинга?
- В чём различие между классификацией и регрессией?
- Что такое кросс-валидация и зачем она нужна?
- Что такое grid search и зачем он нужен?
- Как понять связь офлайн и онлайн метрик?
- Какие тесты используются для сравнения выборок?
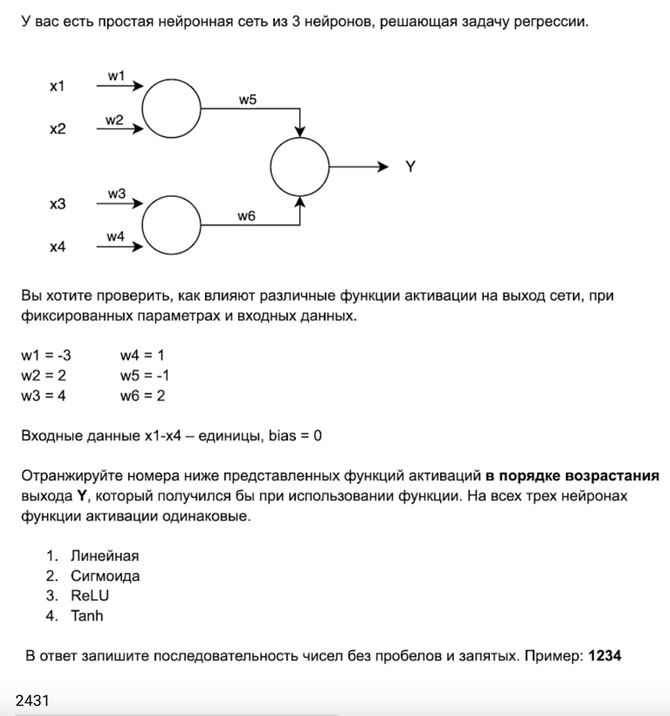
- Что такое функция активации в нейронных сетях и зачем она нужна?
- Как будет выглядеть продолжение регрессии для лин регрессии/деревьев/KNN
- Что такое обучение с учителем, без учителя, с подкреплением? Примеры моделей.
- Могут ли линейные модели / деревья / RF / бустинги выходить за рамки обучающей выборки?
- Применяется ли стандартная кросс-валидация на временных рядах? Почему нет?
- Как делать back-testing валидацию (sliding window)?
- Как решить задачу бинарной классификации целиком: от постановки задачи и подготовки данных до передачи модели заказчику?
- Что такое Data Drift и как его обнаруживать?