Вводные вопросы
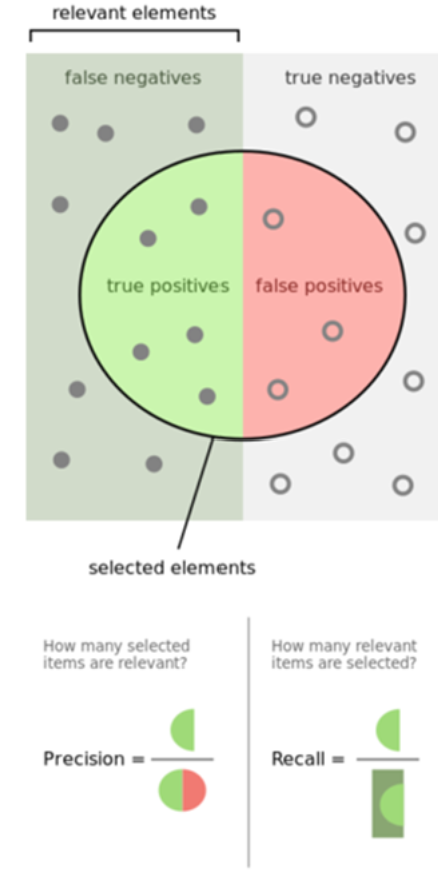
- Какие ответы алгоритмы мы можем получить? (TP, TN, FP, FN)
- Что это такое Confusion matrix, зачем нужна?
- Что такое ошибка 1 и 2 рода?
- Нулевая гипотеза что такое?
- Многоклассовая классификация
- One Vs All
- All vs All
- Чем отличаются MAE / MAPE / WAPE / RMSE? Когда что лучше использовать?
- В каких случаях WAPE предпочтительнее MAPE для прогнозирования спроса с сильной сезонностью?
Регрессии
MAE (Средняя абсолютная ошибка — Mean Absolute Error) Усредняет абсолютные значения ошибок:
MSE (Среднеквадратическая ошибка — Mean Squared Error) Усредняет квадраты ошибок:
RMSE (Среднеквадратическое отклонение — Root Mean Squared Error) Квадратный корень от среднеквадратической ошибки:
Сравнение метрик:
- MAE проще всего понять — это просто средняя ошибка
- MSE более популярна, потому что больше “наказывает” большие ошибки, и обычно это более полезно в прикладных задачах. Менее устойчива к выбросам (из-за квадрата)
- RMSE ещё более популярна, потому что измеряется в тех же единицах, что и “y”
Accuracy
- Что за метрика, как строится?
- Какие недостатки?
- Давай посчитаем её для такой-то задачи
- У нас бинарная классификация, смотрим Accuracy, она растёт, но при этом растёт и лосс (BCE), как такое может быть?
- — кол-во образцов в наборе данных
- — фактическая метка
- — предсказанная метка
- — натуральный логарифм (от e)
Варианты ответа:
- Выбросы в данных, т.к. y_pred у нас находится в логарифме, а в нуле он стремится к бесконечности, то одно значение типа 0.000000001 может дать большой лосс
- Порог, например, если он у нас 0.5, а ответы сетки 0.51, 0.52, 0.53, т.е. не сильно отличаются от порога, то точность растёт, а лосс низкий (т.к. pred низкий)
- Дисбаланс классов
Recall
- Что за метрика, какая у неё формула, как строится?
- Какие недостатки?
- Давай посчитаем её для такой-то задачи
Precision
- Что за метрика, какая у неё формула, как строится?
- Какие недостатки?
- Давай посчитаем её для такой-то задачи
- Что такое P@1, P@3 и т.д.
- Что такое mAP, что это за метрики? (ранжирования)
F-score
- Что за метрика, какая у неё формула, как строится?
- Какие недостатки?
- Что такое гармоническое среднее? Почему не можем просто сложить и поделить на 2?
- Что такое F бетта? Почему F1, а не F3? Что делает бетта коэффициент, изменяет вклад чего R или P? (P)
- Давай посчитаем её для такой-то задачи
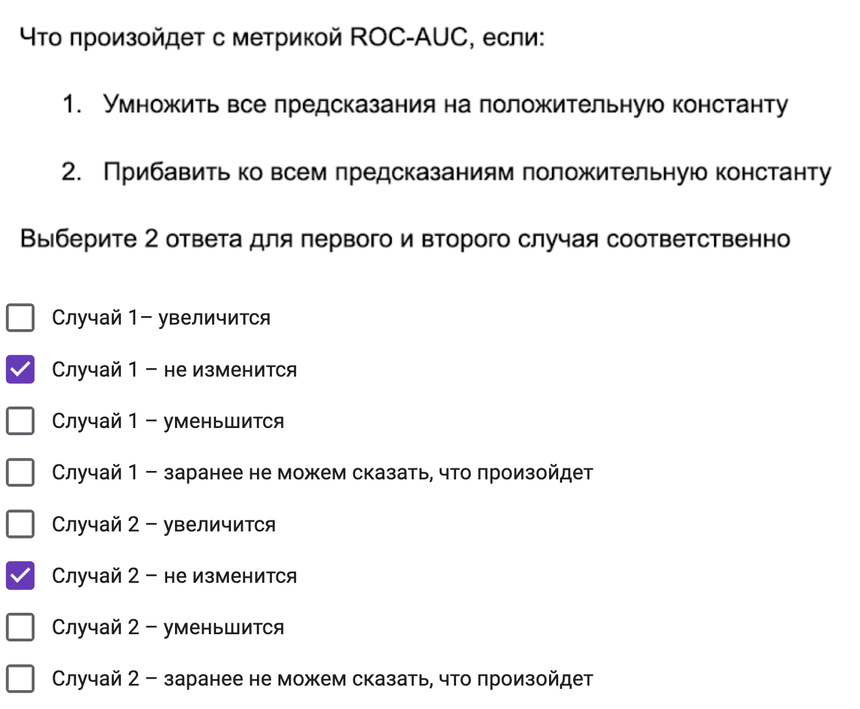
ROC-AUC
- Что за метрика, для чего используется?
- Как строится?
- Какие недостатки? Устойчив ли к дисбалансу классов? Как выглядит при дисбалансе классов?
- Как изменится ROC-AUC, если к функции вероятности мы применим логарифм? Или прибавим число? Или домножим на -1? (Изменится масштаб осей, перевернётся)
- Какой метрикой является ROC-AUC, для чего ещё мы можем его использовать? (ранжирование)
- Давай посчитаем его для такой-то задачи
- Какой ROC-AUC лучше 0.8 или 0.1? Почему?
- Какой результат выдаст для случайных данных?
- Дай интерпретацию ROC-AUC через пары ноликов и единичек.
- Если у нас 500 единичек и 500 ноликов, и мы добавим ещё 500 таких же ноликов с теми же скорами — изменится ли ROC-AUC? Почему?
- Что есть «единица ранжирования» в ROC-AUC?
PR-AUC
- Что за метрика, для чего используется?
- Как строится?
- Какие недостатки? Устойчив ли к дисбалансу классов?
- Как подобрать P/R с её помощью? (зафиксировать на P/R нужной и подбирать по ней противоположную метрику)
- Как ROC-AUC поведёт себя при сильном дисбалансе классов? Что покажет PR-AUC?
- При каком условии стоит смотреть на PR-AUC, а не на ROC-AUC?
Общие вопросы по метрикам
- Bias/variance, что 3? (шум)
- Чем отличается бустинг и бэггинг?
- Давай посчитаем метрики для таблички ниже
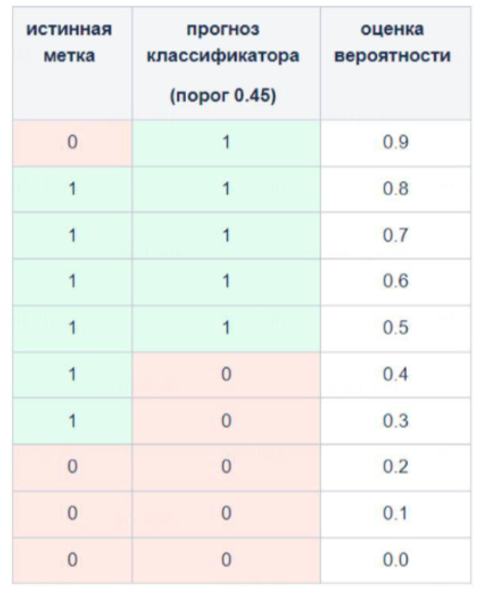
- Что такое микро и макро усреднения? В чём разница? (Микро — усредняем по TP, TN.., макро по P, R, …)
- Что нам лучше иметь много ложноположительных срабатываний или ложноотрицательных (выявление онкологий и фильтрация спама). Какие метрики бы выбрал для этих задач?
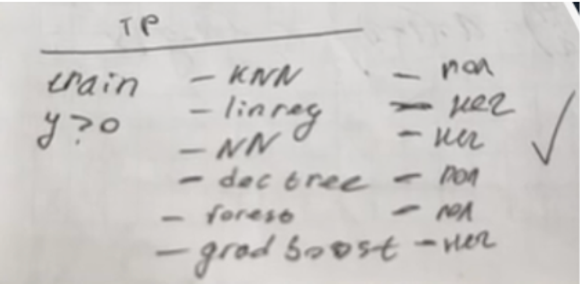
- У нас все y>0, какие алгоритмы могут дать негативный ответ, а какие только положительный
- Тестовые данные состоят из 99% из y=1 и на 1% из y=-1. Модель на тесте предсказывает с вероятностью 50% y=1 и с 50% вероятности y=-1. Посчитать Accuracy, Precision, Recall. (TP=99, FP=1, FN=99, TN=1, Precision=0.99, Recall=0.5, accuracy=0.5)
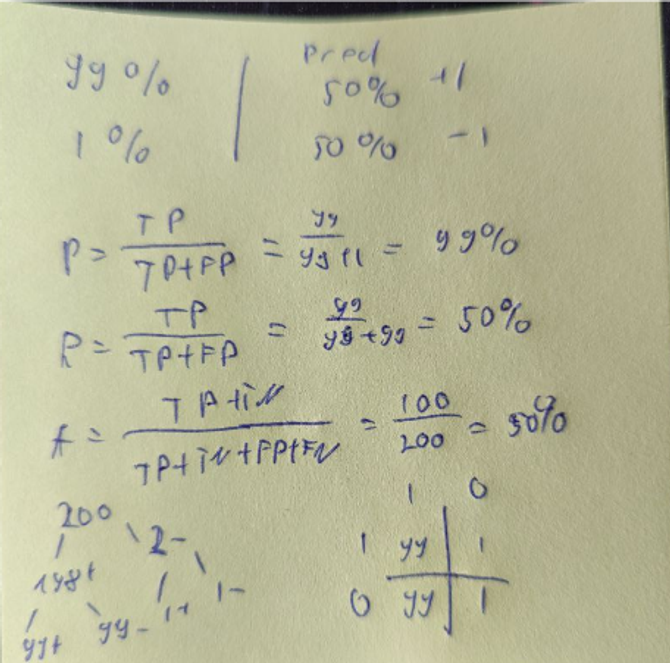
- В какой выборке дерево будет лучше чем лес? (В той выборке, которая состоит из немногих важных фичей)
- Есть много данных (миллион), что лучше использовать, если нужно быстро решение сделать SVM или лог регрессию? (лог регрессию, в ней полином 1 степени, в SVM 2)
- Как считать смещение (bias) на основе ошибок прогноза?
- Какие основные метрики ранжирования знаешь?
- Приведите примеры задач, в которых важнее Precision, и задач, в которых важнее Recall.
- Для чего нужна NDCG? Почему недостаточно Precision@k?